Validação técnica e limitações¶
Esta página é a fonte canônica de honestidade técnica do produto. Auditores, procurement Enterprise, reguladores e clientes em due-diligence devem ler esta página primeiro antes de qualquer material de marketing. Os números do modelo servido conferem-se ao vivo nos endpoints públicos
GET /coverage/claim-readiness,GET /coverage/effective-bandeGET /coverage/promotion-readiness, e no autenticadoGET /coverage/model/info.
Para detalhes profundos, ver também:
- Modelos de propagação — matriz auditável —
fspl,p1812,sionna_rt,sionnaML eitm. - Validação do modelo — a cadeia servida, CV espacial, banda conformal, promoção de artefatos e o fallback ridge.
- Ingestão de observações — fluxo
POST /coverage/observations[/batch].
🏆 Claim de acurácia de campo LIVE (desde 2026-07-13)¶
O engine P.1812/P.1411 (híbrido) + resíduo LightGBM é treinado com
dados reais de drive-test (G-NetTrack Pro com calibração de RX declarada,
geometria de torres licenciada ANATEL/Mosaico) e está servindo predições em
produção (model_source: "residual-lgbm"). P.1411 cobre os caminhos curtos
(<250 m) que o P.1812 declina — o baseline efetivo (baseline_engine) é
declarado no artefato e cruzado com esta prosa pelo sync. A tabela abaixo é
gerada automaticamente do artefato commitado por
scripts/sync_claim_surfaces.py — os números
não podem divergir de GET /coverage/model/info.
| Métrica (artefato real) | Valor |
|---|---|
cv_rmse_db (CV espacial, folds por célula h3_res8, k=5) |
7,85 dB |
Banda conformal 90% (q_abs_db, resíduos OOF reais) |
±12,54 dB |
| Banda servida em produção (override de campo) | de ±16,12 a ±21,26 dB conforme a classe de sinal — override de campo (recalibração automática de campo, decisão widen), aplicado em 2026-10-26 · cobertura medida ao vivo: GET /coverage/effective-band |
n_observations |
76.139 (100% drive-test real) |
| Envelope calibrado | 5G NR n78 3,5 GHz + LTE B28 700 MHz/B1/B3/B7 (Vivo, TIM, Claro), suburbano/urbano de Brasília |
baseline_engine |
p1812-p1411-hybrid (P.1812/P.1411) |
data_provenance |
real |
field_accuracy_claim |
true |
| Grau sole-source (dentro do envelope) | não atingido — modelo em grau de triagem (gate: <8 dB e ≥5.000 obs. reais) · resposta ao vivo: GET /coverage/promotion-readiness |
| Verificação ao vivo | GET /coverage/claim-readiness (público, métricas do artefato + banda servida) + GET /coverage/effective-band (público, banda aplicada + cobertura medida) + GET /coverage/model/info (autenticado) |
A decisão de promoção tem QUATRO portas, não duas.
GET /coverage/promotion-readiness (módulo promotion_readiness) só
devolve ready=true quando todas passam — a tabela acima cita apenas
os dois limiares estáticos porque são os únicos que o sync offline das
superfícies consegue observar:
| Porta | O que mede | Observável offline? |
|---|---|---|
accuracy_gate |
CV-RMSE efetivo do stack servido < 8 dB | sim (artefato) |
data_gate |
≥ 5.000 observações reais (data_provenance="real") |
sim (artefato) |
field_integrity_gate |
nenhuma torre de onboarding com bias sistemático sem waiver nomeado | não — censo ao vivo |
health_gate |
PSI de covariate-drift e meia-largura conformal servida dentro do teto | não — telemetria ao vivo |
As duas últimas são dispensadas com motivo nomeado no sync offline
(allow_missing_psi_reason / allow_missing_onboarding_reason) e
permanecem exigidas no endpoint ao vivo.
⚠️ A dispensa corre a favor do otimismo, e é essa a limitação. Como o sync offline renuncia às duas portas de telemetria, ele pode publicar um grau que a resposta ao vivo recusaria — basta que o PSI ou o censo de torres de onboarding falhem agora. O texto publicado é, por construção, no máximo tão severo quanto o ao vivo, nunca mais. Por isso ele não substitui o endpoint: a resposta com autoridade é sempre
GET /coverage/promotion-readiness, e é ela que deve ser citada em qualquer decisão.Nota de contrato (2026-09, fechada em #2765). Até
d8b77814a docstring pública do próprio endpoint (telecom_tower_power_api.py), oopenapi.jsonversionado e os clientes gerados a partir dele (frontend/src/api-schema.d.ts, SDK JavaScript) diziam THREE gates e omitiam ofield_integrity_gate— dois contratos contraditórios, sendo o correto o desta tabela. A docstring passou a declarar FOUR gates com ofield_integrity_gatealinhado apromotion_readiness.py, as superfícies foram regeneradas pelos geradores canônicos, etests/test_promotion_readiness_contract_prose.pylê a prosa na fonte e em cada superfície derivada e recusa que volte a dizer «three gates» ou a omitir uma porta que o payload aplica.
Honestidade metodológica: o primeiro artefato candidato (2026-07-12) reportava 3,82 dB — número descartado por vazamento (KFold por linha embaralhada sobre fixes quase-duplicados de caminhada). Os números publicados vêm de folds agrupados espacialmente (H3 res-8), sem vazamento entre folds; a expansão multi-operadora (Vivo n78 + TIM B3, PR #1128) foi provada em holdout genuíno (rota TIM coletada após o treino: 6,22 dB).
Envelope calibrado (limitação honesta): declarado na tabela acima.
Fora desse envelope não há recusa nem troca automática de modelo: o
resíduo continua a responder, com a banda de extrapolação, mais larga
(rf_engines/residual_model.py; não há teste de envelope no caminho de
serviço). O ridge (§3) só responde quando o resíduo não responde. Meta
seguinte: mais rotas/morfologias para promoção sole-source.
1. O que o produto faz, com honestidade¶
O TELECOM-TOWER-POWER (TTP) é uma API sobre o dado público de licenciamento da ANATEL, com predição de RF de grau triagem calibrada para o Brasil, vendida por assinatura mensal. O comprador não é a operadora:
- Laudistas e entidades avaliadoras de RNI, empresas de licenciamento e engenharia e tower-cos — triagem de RNI co-site pelo Ato 17.865, gêmeo do site e fila de reavaliação (Triagem de RNI).
- Integradores e revendas de rádio privativo — planilha de leads por UF (Leads de rádio privativo).
- Consultorias de RF e integradores de acesso fixo sem fio — minuta de cobertura rural (Minuta de cobertura rural).
Com operadora Tier-1, só sob contrato e depois de uma PoC medida.
Não é substituto de ATOLL, Planet, Asset ou CelPlan para planejamento RAN macro Tier-1, simulação de tráfego/capacidade multi-célula, ou calibração contínua por drive-test em escala nacional. Também não é laudo: o relatório protocolado exige engenheiro responsável com CREA/ART. Estes limites estão declarados na página inicial (Para quem é (e para quem não é)).
2. Engine de propagação — estado atual real¶
O TTP não usa um único modelo. A engine é selecionada pelo campo
engine da API (ou engine='auto' com critérios documentados em
propagation-models.md):
| Engine | Método | Tier mínimo | Status |
|---|---|---|---|
fspl |
FSPL + 1ª zona de Fresnel + knife-edge único (k=4/3) | Free (em /analyze_link) |
GA em /analyze_link, default de /coverage/interference e no gráfico do PDF; não aceito em /coverage/predict. Cálculo no rf-kernel em Go (RF_KERNEL_PCT=100), com fallback para o LinkEngine Python |
p1812 |
ITU-R P.1812 (Py1812, multi-knife-edge Deygout) | Pro | Default de /coverage/predict e baseline do resíduo LightGBM (P.1411 abaixo de 250 m) |
itm |
Longley-Rice / Irregular Terrain Model (NTIA) | Pro+ | Disponível (rf_engines/itmlogic_engine.py) |
sionna_rt |
Ray-tracing 3D (Mitsuba 3 / Dr.Jit, materiais ITU-R P.2040) | Business / Enterprise / Ultra (RT_ALLOWED_TIERS) |
Raster/cena assíncrono servido em CPU — RT_ASYNC_BACKEND (default rq, rt_dispatch.py) enfileira em ttp_rt para o rt-worker, que roda SIONNA_RT_BACKEND=auto na variante CPU gorda (INSTALL_RT_STACK=1): traçado real em LLVM quando a cena tem geometria, fail-open para o stub fspl_stub (cego à geometria) quando não tem. tracer=sionna_rt nomeia o motor, não o hardware (#2749). As chamadas diretas por enlace e a interferência (RT_GPU_BACKEND, gpu_dispatch.py) usam o engine real e reportam indisponível sem o stack/cena — não caem em silêncio para o stub. Não promovido para serving. AWS Batch aposentado (#398/#410); #403 fechou o contrato de execução F4.2, a física está em #3164 |
sionna (ML) |
Modelo treinado (TFLite) | — | Bloqueado por guard-rail — artefato v2 é 100% sintético |
Default de cobertura. POST /coverage/predict usa engine='p1812'
por padrão (CoveragePredictRequest.engine em
telecom_tower_power_api.py; estado ao vivo em GET /health/engine).
Com o artefato residual carregado, a resposta é a cadeia P.1812/P.1411 +
resíduo LightGBM descrita em Validação do modelo.
O fspl continua sendo o mais fraco dos três modelos físicos: para LOS
curto (<5 km, antenas altas, terreno suave) é razoável; para NLOS,
multi-obstáculo ou clutter denso é insuficiente. Por isso ele não é
oferecido como engine de cobertura.
3. Fallback ridge (coverage_model.npz)¶
O ridge não é o modelo que responde /coverage/predict hoje: quem
responde é a cadeia P.1812/P.1411 + resíduo LightGBM (topo desta página e
Validação do modelo). O ridge só responde quando o
resíduo não responde, e o que vem no lugar depende da engine pedida; os
casos estão em
Validação do modelo — ridge-v1 (fallback).
| Item | Valor |
|---|---|
| Algoritmo | Ridge regression (NumPy), 17 features físicas + terreno |
| Versão carregada | ridge-v1, treinada em 13/07/2026; degraded = true (idade acima de 30 dias) — GET /health/ready, 10/10/2026 |
| Entrega do retreino ao serviço web | Desligada por decisão de registro (#2819, opção A, 19/10/2026), com revisão em 19/01/2027 ou na primeira campanha de campo fora do Centro-Oeste, o que vier antes: s3_delivery.state = decided_off, expected = false, COVERAGE_MODEL_S3_URI sem definir — GET /health/ready, 20/10/2026. O serviço carrega o artefato embutido na imagem, que a decisão mantém como reserva; o degraded = true da linha acima é esperado sob ela (Validação do modelo — ridge-v1 (fallback)) |
cv_rmse_db do artefato carregado |
12,84 dB, k-fold aleatório (k=5) — coverage_model_cv_rmse_db em GET /metrics (autenticado), 10/10/2026 |
| Referência citada nas superfícies de claim | ~14,9 dB (procurement_cv_rmse_db em GET /platform/maturity) |
O número de marketing histórico "RMSE 12,94 dB" corresponde ao
rmse_dbin-sample do snapshot inicial, não aocv_rmse_dbem holdout. O k-fold do ridge embaralha linhas e não separa geografia: não é comparável ao CV espacial do resíduo. Os números por banda e morfologia estão em Validação do modelo — ridge-v1 (fallback).
Procedente: o auditor que apontar que um erro dessa ordem é
inaceitável para link budget contratual está tecnicamente correto.
Nem o ridge nem a cadeia servida são vendidos para esse uso: a cadeia
servida é de grau triagem, e o grau sole-source ao vivo está em
GET /coverage/promotion-readiness.
4. Dataset de treino — composição honesta¶
Esta seção descreve o dataset do ridge de fallback em maio/2026. A cadeia servida é treinada com 124.309 medições reais de drive-test, agregadas em 76.139 pontos, com CV espacial (Validação do modelo §2).
| Camada | Fonte | Volume (mai/2026) | Realidade |
|---|---|---|---|
| Seed sintético | Sionna RT + P.1812 com σ=4 dB log-normal | ~10–11 k linhas | Cap do RMSE ≈ 6,5 dB (variância injetada do shadowing) |
Observações reais (link_observations) |
POST /coverage/observations[/batch] + import drive-test |
~1 k linhas | Crescimento orgânico via API; ingestion plumbing entregue 2026-05 |
| Validação independente | k-fold (k=5, seed=42) sobre o set acima | — | Não-estratificada por região IBGE ainda — limitação reconhecida |
Limitações reconhecidas¶
- Maioria do dataset é sintética, e o seed sintético foi gerado
pelo próprio P.1812 + Sionna. O
cv_rmse_dbreportado mede em grande parte "consigo reproduzir meu próprio simulador". Auditor regulatório está certo em descontar esse número. - Holdout geográfico ausente. Hoje o k-fold é aleatório. Falta leave-one-region-out (N / NE / CO / SE / S) e leave-one-band-out. Sem isso, regiões sub-representadas (Amazônia, Pantanal) podem ter RMSE 20+ dB sem aparecer no agregado.
- Calibração por banda parcialmente entregue:
coverage_model_<MHz>.npzpor banda comercial brasileira, mas treinada com o mesmo dataset sintético-dominante. - Guard-rail Sionna ML. O artefato v2 é 100% sintético — a engine
sionnaé propositalmente invisível em/coverage/enginesenquantosynthetic_only=Trueno sidecar (propagation-models.md §"Sionna ML").
Critério de promoção (gate Phase-3 do roadmap)¶
- ≥ 5 k observações reais com
source ∈ {drive_test, drivetest_fleet}. - Estratificação por região IBGE + banda + morfologia.
cv_rmse_db< 8 dB no fold geográfico (leave-one-city-pair-out).- Sem regressão por tier nas métricas residuais
(
coverage_observation_residual_db_*no Prometheus).
Detalhe completo no documento interno ROADMAP.md (seção Q3 / 2026 — Real drive-test ML
retrain). A porta implementada é phase3_gate em
scripts/retrain_coverage_model.py, que recusa a publicação quando não
avalia.
5. Terreno e clutter¶
Resolução do DEM — limitação conhecida¶
A cadeia de elevação em produção, medida em 10/10/2026 em
GET /platform/dem-status, é nasadem+alos+srtm3: NASADEM 30 m → ALOS
30 m e só cai em SRTM-3 (90 m) como último recurso. (Sem
DEM_SOURCES, o default do código é dem_sources.DEFAULT_DEM_CHAIN =
copernicus,alos,nasadem,srtm1,srtm3.) Em terreno
acidentado brasileiro (Serra do Mar, Mantiqueira, Caparaó, Espinhaço)
os 90 m do último elo podem esconder knife-edges críticos para Fresnel,
e nenhum tile de 30 m hidratado para a AoI derruba o cálculo para esse elo.
O artefato residual servido não usa perfil de relevo no baseline
(Validação do modelo §4).
- Mitigação atual: capped knife-edge penalty no
worker.py— viesa conservadoramente (rejeita alguns links marginais que fechariam), reduzindo falsos positivos ao custo de falsos negativos. - Já em runtime: os elos de 30 m (NASADEM e ALOS na cadeia de produção) são drop-in e sem custo de licença — a cobertura efetiva depende dos tiles hidratados, não da configuração.
- Roadmap: oferecer ALOS PALSAR 12,5 m como upgrade Enterprise
opcional para enlaces > 5 km em terreno classificado
rural_mountainous.
MapBiomas clutter — escopo real¶
O sampler de uso/cobertura do solo (MapBiomas Coleção 9) está ativo em produção:
- 10 classes one-hot (Forest / Savanna / Grassland / Pasture / Mosaic / Urban / Bare / Water / Soybean / Other).
- Cache Redis (TTL 30 d) + LRU(8192) in-process.
/coverage/predictretornaclutter_class+clutter_labelquandorx_lat/rx_lonsão fornecidos.
Limitação: MapBiomas é land-cover (classe de uso do solo),
não altura de edificações nem footprint 3D. Para enlaces urbanos
o ridge aprende perda de clutter por classe, não por geometria. O
resíduo servido usa, além da classe de clutter (ESA WorldCover no treino),
a altura de edificação no RX e a fração do percurso obstruída por
edificações, ambas do GHSL (blocos building_height e path_obstruction
do sidecar).
Cadastro 3D público de edificações urbanas brasileiras não existe na
escala nacional (diferente de OS UK ou TomTom Munique). Para
densamente urbano, a recomendação é Sionna RT 3D (Enterprise) com
cena Mitsuba construída de OSM + alturas inferidas.
6. IA (LLM) — risco de alucinação e mitigações¶
A explicação em linguagem natural via /bedrock/chat e
/bedrock/compare pode alucinar valores numéricos. LLM não é fonte
de verdade para link margin. As rotas mantêm o nome histórico; o backend
é escolhido por LLM_PROVIDER, e o ativo em produção é o Ollama
self-hosted (GET /platform/maturity →
hosting_portability.dependencies.llm_inference).
Posição declarada¶
A IA explica o número computado pelo motor determinístico
(/analyze ou engine selecionada). Ela não é autorizada a citar
margem de enlace que não tenha vindo do motor.
Mitigações em produção¶
- Contrato estrito de I/O. O prompt do
bedrock_service.pyinclui o resultado numérico do motor + contexto físico, com instrução explícita de não inventar valores de margem (bedrock_service.py). - Audit log imutável. Toda saída de IA passa pelo
audit_log.pycom hash da entrada + resposta. Auditor pode reproduzir qualquer resposta a partir do log. - Disclaimer obrigatório em todo PDF e em toda resposta IA: "explicação automática não substitui parecer técnico de engenheiro responsável (CREA)."
Mitigações em backlog (gate Q3/2026)¶
- Guard determinístico server-side. Parsear resposta da IA, extrair valores numéricos citados, comparar com o resultado da engine; se divergência > 0,5 dB, substituir pelo número canônico antes de devolver ao cliente.
- Eval suite golden-cases. ~50 enlaces conhecidos (licenciados públicos no MOSAICO ANATEL com RSSI medido publicado) rodando em CI nightly. Falha se a IA citar margem fora de tolerância.
7. O que o cliente recebe na resposta da API (auditável)¶
Toda resposta de /coverage/predict, /coverage/engines/predict e
/analyze inclui:
engine_used— qual modelo físico produziu o número.confidence— 0,75 para modelos empíricos na banda calibrada, 0,55 para fallback FSPL.cv_rmse_db— RMSE holdout do modelo ML usado, quando aplicável.model_sourceemodel_version(/coverage/predict) —residual-lgbme a identidade do artefato treinado que respondeu,residual_lgbm-<dataset_max_id>-<hash>, quando a cadeia servida respondeu;local-model/ridge-v1no fallback ridge. No modo grade, o par é o da fonte que respondeu mais células. A identidade sai só dos bytes do booster e do sidecar, é a mesma em todas as réplicas e muda a cada retreino promovido; quando não pode ser calculada, a previsão sai comresidual_lgbm-unknown. A receita para conferi-la está em Validação do modelo.
Para qualquer cenário onde o cliente requer mais de uma engine como
evidência, POST /coverage/engines/compare retorna a tabela
lado-a-lado com todas as engines disponíveis. Este é o procedimento
recomendado para parecer técnico ou submissão regulatória.
8. Validação cruzada por região — planejada (🟡 não disponível hoje)¶
Status honesto: o CV publicado da cadeia servida é espacial (
GroupKFoldpor célula H3 res-8, 5 folds; tabela do topo da página). O que continua planejado, não entregue, é o leave-one-region-out por macrorregião IBGE: as observações do artefato servido estão todas no Centro-Oeste (Brasília;conformal.by_regiondo sidecar tem uma única região), então não há como medir a transferência entre regiões. Nenhum número regional é reportado nesta página até que o fold descrito abaixo seja rodado e auditado. O ridge de fallback (§3) usa k-fold com shuffle aleatório, que não controla viés geográfico.
8.0 Procedência dos dados e selo de acurácia (entregue)¶
O artefato residual_lightgbm versionado no repositório foi treinado
sobre dados reais de drive-test (data_provenance = "real" no
sidecar). As métricas dele (tabela do topo desta página, gerada do artefato) são
as que GET /coverage/claim-readiness reporta em produção, também com
procedência real. A procedência é declarada explicitamente em vez
de inferida:
- O sidecar do booster carrega
data_provenance ∈ {synthetic, real, mixed, unknown, none}(scripts/train_residual_model.py --provenance). rf_engines/residual_model.accuracy_grade()deriva um selo:data_provenance != "real"(oucv_rmseausente) ⇒grade = "pipeline_validation_only"efield_accuracy_claim = False— um CV-RMSE baixo sobre dados sintéticos nunca é uma alegação de acurácia de campo;data_provenance == "real"⇒ ladderplanejamento (≤ 8 dB) / triagem (8–12 dB) / screening (> 12 dB)comfield_accuracy_claim = True.- Esses campos são expostos na API em
GET /coverage/model/info(residual_engine.data_provenance+accuracy_grade) e propagados ao blocoaudit_gate/GET /health/audit-gate(field_accuracy_claim,data_provenance) — um gate verde sobre dados sintéticos não pode ser lido como alegação de campo calibrada. - Relatório reproduzível:
scripts/residual_rmse_honesty_report.pydemonstra que o piso de CV-RMSE sintético ≈ ruído injetado (cv_rmse / sigma ≈ 1.0) e, com--db-path, mede a perna real (guardMIN_REAL_OBSERVATIONS=200para dados insuficientes). - Sentinela em CI: o workflow
residual-honesty-gateroda o relatório com--gateem cada PR que toca o stack residual + cron semanal, falhando se algum fold sintético reivindicar acurácia de campo ou se ormse_over_sigmaescapar da banda plausível (sinal de vazamento de rótulo ou pipeline quebrado). A perna real liga-se sozinha quando umdb_pathcom ≥ 200 observações reais é fornecido.
Leitura para o auditor: o pipeline ML, o gate de promoção e o selo de procedência existem e são honestos hoje. O selo
field_accuracy_claim = Truesó é emitido sobre observações reais, e o artefato servido o emite:field_accuracy_claim = trueemGET /coverage/claim-readiness(10/10/2026). O que ainda depende de massa crítica é o grau por região (§8.3).
8.0.1 Intervalos conformais — incerteza calibrada (entregue)¶
Além do ponto basic_loss_db, o motor residual agora emite uma banda
de predição conformal distribution-free, calibrada nos resíduos
out-of-fold da validação GroupKFold (cross-conformal / CV+). Como cada
observação é pontuada pelo booster que nunca viu o seu grupo
espacial, esses resíduos são escores de não-conformidade honestos —
sem vazamento de treino.
- Cálculo (
scripts/train_residual_model._compute_conformal): para nível-alvo1 − α(defaultα = 0.1, i.e. 90 %), a meia-largura é o quantil de amostra-finita
$$q = \mathrm{Quantil}_{\lceil (n+1)(1-\alpha) \rceil / n}\big(|r_i|\big),$$
onde $r_i = y_i - \hat y_i$ são os resíduos OOF. Sob trocabilidade,
a banda simétrica $[\hat y - q,\ \hat y + q]$ garante cobertura
marginal $\ge 1 - \alpha$.
- Sidecar: bloco conformal com method = "cv_split_conformal_abs",
alpha, coverage, q_abs_db (meia-largura), q_lo_db/q_hi_db
(quantis assinados, p/ diagnosticar viés assimétrico), n_calibration
e level.
- Inferência (rf_engines/residual_model.conformal_interval): a
perda pontual recebe extra["conformal"] = {loss_interval_db: [lo, hi],
half_width_db, coverage, …}. O limite superior da banda é a maior
perda (sinal mais fraco) — a leitura conservadora para link budget.
- Honestidade preservada: o bloco carrega data_provenance e
field_accuracy_claim, espelhando accuracy_grade(). Um intervalo
calibrado sobre dados sintéticos valida a maquinaria de
cobertura — não a cobertura de campo — e por isso sai com
field_accuracy_claim = False. Só calibração sobre drive-test real
emite uma banda com alegação de campo.
- Exposto em GET /coverage/model/info
(residual_engine.conformal) e em cada LossEstimate do motor
residual_lgbm.
Validação de cobertura (auditável, entregue)¶
Uma banda só é honesta se a cobertura prometida for de fato
verificada. O bloco conformal passa a registrar a cobertura
empírica medida, e a quebra por região mede se a garantia sobrevive à
transferência espacial:
- Cobertura marginal (
conformal.empirical_coverage): fração dos resíduos de calibração efetivamente cobertos por $\pm q$. Por construção do quantil conformal, $\text{empirical_coverage} \ge 1 - \alpha$ — torna a garantia auditável em vez de apenas afirmada.mean_width_db = 2qexpõe a nitidez (uma banda larga que "cobre" não é de graça). No artefato servido:empirical_coverage = 0,90paracoverage = 0,90(também emGET /coverage/claim-readiness). - Cobertura fora-de-região (
cv_by_region[*].conformal_coverage): para cada macrorregião IBGE, a meia-largura é calibrada nas demais regiões e a cobertura é medida na região retida (mesma malha leave-one-region-out do RMSE por região). A trocabilidade é violada entre regiões, então este número honestamente revela se a banda de 90 % continua cobrindo ~90 % num território não visto. O artefato servido só tem dados do Centro-Oeste e não trazcv_by_region: a cobertura fora-de-região não é medida hoje. Nunca é apresentada como paridade com ATOLL/Planet/CelPlan.
Bandas condicionais por região (Mondrian, entregue)¶
Uma única banda global pode sub-cobrir em territórios não vistos
(a medida fora-de-região acima serve para detectar isso) e, dentro de uma
região, ser larga demais. As bandas
conformais Mondrian fecham os dois lados — estratificam os mesmos
resíduos OOF honestos por macrorregião IBGE e calibram uma meia-largura
dentro-da-região por região
(scripts/train_residual_model._compute_mondrian_conformal):
- Sidecar:
conformal.by_region[<nome>]comregion_code(N/NE/CO/SE/S),q_abs_dblocal,alpha,coverage,n_calibration,empirical_coverageemean_width_db. - Inferência: quando um ponto cai numa macrorregião com banda local
(o motor resolve a região do RX via
br_macroregions.point_to_macroregion, com cache LRU e quantização de ~0,25° — custo pago somente quando o artefato traz bandas Mondrian),conformal_intervaltroca a meia-largura pooled pela local e marcamondrian = true+region. Cai silenciosamente para a banda marginal quando não há calibração de região utilizável (artefatos antigos, ou pontos fora do Brasil). - Garantia sob trocabilidade interna: a trocabilidade vale dentro
de uma região (violada apenas entre regiões), então a banda local é o
intervalo honesto para um ponto naquela região. No artefato servido há
uma única banda de região, a do Centro-Oeste, calibrada sobre os mesmos
pontos da banda marginal e igual a ela (o
q_abs_dbda tabela do topo da página). O sidecar traz também bandas por classe de clutter, por clutter × altura e por faixa de frequência (Validação do modelo §2). - Honestidade preservada: o bloco
by_regionherdadata_provenance/field_accuracy_claimdo blococonformalpai — uma banda de região calibrada sobre dados sintéticos nunca é uma alegação de campo.
Observabilidade da calibração conformal (Prometheus, entregue)¶
No carregamento do artefato o motor residual publica a calibração conformal como gauges Prometheus (best-effort — nunca afeta load/inferência), de modo que a saúde da banda de incerteza fica visível em produção sem depender de um request de predição:
residual_conformal_halfwidth_db{scope}— meia-largura conformal em dB.scope="marginal"para a banda pooled;scope="N|NE|CO|SE|S"para cada macrorregião IBGE quando o artefato traz bandas Mondrian.residual_conformal_empirical_coverage{scope}— cobertura empírica medida no fold de calibração (mesma convenção descope).residual_conformal_nominal_coverage— cobertura nominal alvo (ex.:0.9).residual_conformal_regions— número de macrorregiões com banda Mondrian publicada (0para artefatos marginais-apenas ou sem bloco conformal).
Quando o artefato é removido/desabilitado os gauges são zerados/limpos, de
forma que um scrape com residual_conformal_nominal_coverage == 0 sinaliza
motor residual ausente. Um afastamento sustentado entre empirical_coverage e
nominal_coverage denuncia calibração degradada (drift de distribuição) antes
de qualquer impacto silencioso na banda entregue ao usuário.
Resumo (TL;DR para auditor):
- Método: 5-fold leave-one-region-out — treina em 4 macrorregiões, testa na 5ª (N / NE / CO / SE / S).
- Métricas:
RMSE,MAEebiaspor fold + média ± desvio padrão entre folds.- Fontes:
observation_store.py(drive-test reais ingeridos viaPOST /coverage/observations[/batch]) cruzado com ANATEL MOSAICO/SMP + OpenCellID para geometria do enlace.- Gate de promoção:
cv_rmse_db < 8 dBem todas as 5 regiões.Status atual: 🟡 implementado em
scripts/train_residual_model.leave_one_region_out_cv, sem execução publicável: as observações reais do artefato servido estão todas no Centro-Oeste.
Implementação de referência (scripts/train_residual_model.leave_one_region_out_cv):
from sklearn.model_selection import LeaveOneGroupOut, cross_validate

logo = LeaveOneGroupOut()
groups = X["ibge_region"]  # 0=N 1=NE 2=CO 3=SE 4=S
scoring = {
    "rmse": "neg_root_mean_squared_error",
    "mae":  "neg_mean_absolute_error",
}
cv_results = cross_validate(model, X, y, groups=groups, cv=logo, scoring=scoring)
rmse = -cv_results["test_rmse"]
mae  = -cv_results["test_mae"]
print(f"RMSE: {rmse.mean():.2f} ± {rmse.std():.2f} dB")
print(f"MAE:  {mae.mean():.2f} ± {mae.std():.2f} dB")
Saída agregada que esta página publicará (linha Média ± std da tabela abaixo):
RMSE: <pendente> ± <pendente> dB
MAE:  <pendente> ± <pendente> dB
Quando a massa crítica de observações por região for atingida (§8.3), esta página publicará a tabela abaixo preenchida — uma linha por macrorregião como fold de teste, mais a linha agregada média ± std:
| Fold de teste | RMSE (dB) | MAE (dB) | n_observações |
|---|---|---|---|
| Norte (N) | pendente | pendente | pendente |
| Nordeste (NE) | pendente | pendente | pendente |
| Centro-Oeste (CO) | pendente | pendente | pendente |
| Sudeste (SE) | pendente | pendente | pendente |
| Sul (S) | pendente | pendente | pendente |
| Agregado (5 folds) | mean ± std: pendente ± pendente | mean ± std: pendente ± pendente | — |
A tabela é deliberadamente publicada com valores
_pendente_hoje. Auditor / procurement deve interpretar como: o pipeline existe, o gate existe, os números regionais não existem até que o dataset cumpra o critério da §8.3.
Breakdown de variância por região¶
Para tornar visível a heterogeneidade entre macrorregiões (não apenas a
variância entre folds), o helper
scripts/train_residual_model.leave_one_region_out_breakdown itera sobre os
splits do LeaveOneGroupOut, treina/avalia região-por-região e devolve uma
tabela com RMSE, MAE, desvio padrão do erro intra-região e contagem de
amostras:
import numpy as np
import pandas as pd
from sklearn.metrics import mean_absolute_error, mean_squared_error
from sklearn.model_selection import LeaveOneGroupOut

logo = LeaveOneGroupOut()
groups = X["ibge_region"]  # 0=N 1=NE 2=CO 3=SE 4=S

regional_results = []
for train_idx, test_idx in logo.split(X, y, groups):
    region = X.iloc[test_idx]["ibge_region"].mode()[0]
    model.fit(X.iloc[train_idx], y.iloc[train_idx])
    y_pred = model.predict(X.iloc[test_idx])
    y_test = y.iloc[test_idx].values

    rmse = float(np.sqrt(mean_squared_error(y_test, y_pred)))
    mae  = float(mean_absolute_error(y_test, y_pred))
    error_std = float((y_test - y_pred).std())

    regional_results.append({
        "Região": region,
        "RMSE": round(rmse, 2),
        "MAE":  round(mae, 2),
        "Std":  round(error_std, 2),
        "Amostras": len(test_idx),
    })

df_regional = pd.DataFrame(regional_results)
print(df_regional.to_markdown(index=False))
Tabela publicada (preenchida quando o gate da §8.3 for atendido):
| Região | RMSE (dB) | MAE (dB) | Std (dB) | Amostras |
|---|---|---|---|---|
| Norte | pendente | pendente | pendente | pendente |
| Nordeste | pendente | pendente | pendente | pendente |
| Centro-Oeste | pendente | pendente | pendente | pendente |
| Sudeste | pendente | pendente | pendente | pendente |
| Sul | pendente | pendente | pendente | pendente |
A coluna Std é o desvio padrão dos resíduos (y_test - y_pred) dentro
de cada região, ortogonal à coluna ± std da tabela anterior (que mede a
variabilidade da métrica entre os 5 folds). Auditor deve interpretar:
RMSE/MAEaltos numa região isolada → o modelo treinado nas outras 4 não generaliza bem para aquela geografia (clutter / clima / densidade diferentes).Stdalto numa região → mesmo dentro daquela região o erro é heteroscedástico (possivelmente concentrado em sub-morfologias específicas).Amostrasbaixo numa região → o número da linha é estatisticamente fraco e não deve ser usado como evidência sozinho.
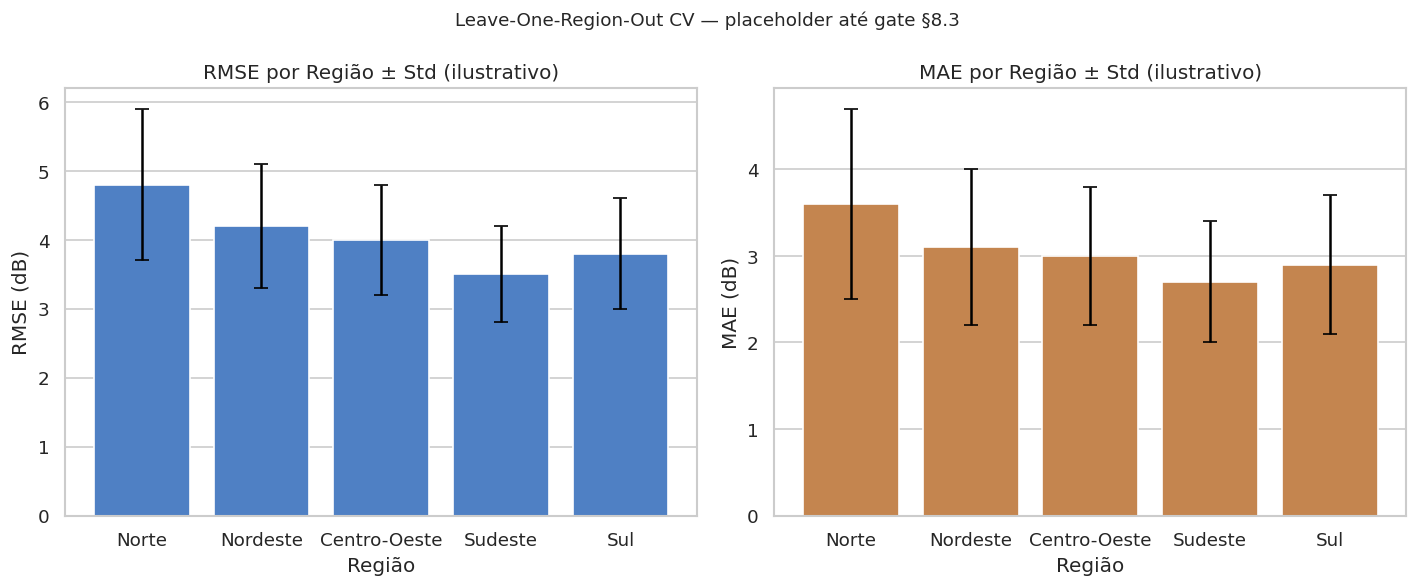
Visualização (scripts/plot_cv_regional_errorbars.py, valores ilustrativos
até o gate da §8.3 ser atendido — barras = média, whiskers = ± Std
intra-região):
import seaborn as sns
import matplotlib.pyplot as plt

fig, ax = plt.subplots(1, 2, figsize=(12, 5))
sns.barplot(data=df_regional, x="Região", y="RMSE", ax=ax[0])
ax[0].errorbar(x=range(len(df_regional)), y=df_regional["RMSE"],
               yerr=df_regional["Std"], fmt="none", ecolor="black", capsize=4)
ax[0].set_title("RMSE por Região ± Std")

sns.barplot(data=df_regional, x="Região", y="MAE", ax=ax[1])
ax[1].errorbar(x=range(len(df_regional)), y=df_regional["MAE"],
               yerr=df_regional["Std"], fmt="none", ecolor="black", capsize=4)
ax[1].set_title("MAE por Região ± Std")

plt.tight_layout()
plt.savefig("docs-site/docs/operations/assets/cv_regional_errorbars.png")
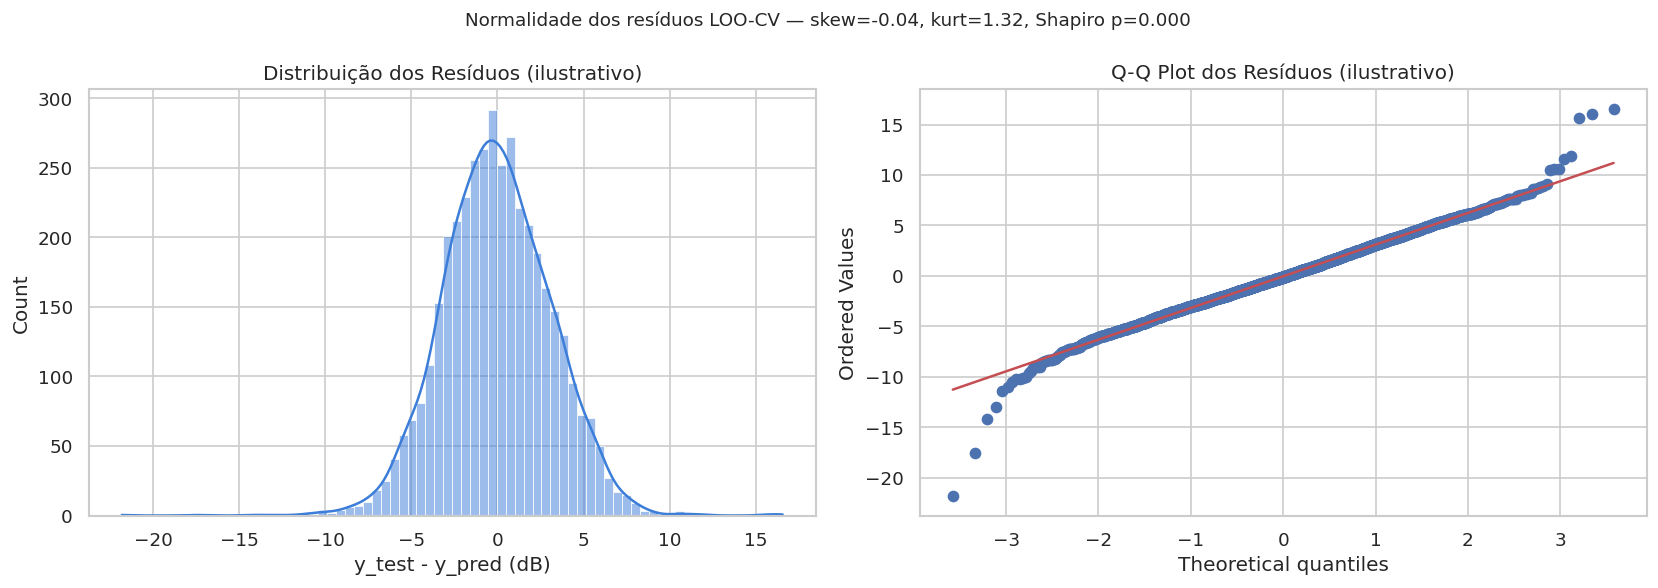
Normalidade dos resíduos¶
Para validar se os intervalos de confiança calculados a partir de mean ± std
são interpretáveis sob suposição gaussiana, o helper
scripts/plot_residuals_normality.py agrega y_test - y_pred de todos os
folds e reporta skewness, kurtosis e Shapiro-Wilk p-value, além de
histograma + KDE e Q-Q plot:
import matplotlib.pyplot as plt
import scipy.stats as stats
import seaborn as sns

# residuals = concat(y_test_fold - y_pred_fold) para os 5 folds
print(f"Skewness: {stats.skew(residuals):.3f} | "
      f"Kurtosis: {stats.kurtosis(residuals):.3f}")
shapiro_stat, shapiro_p = stats.shapiro(residuals[:5000])
print(f"Shapiro-Wilk p-value: {shapiro_p:.4f}")

fig, axes = plt.subplots(1, 2, figsize=(14, 5))
sns.histplot(residuals, kde=True, ax=axes[0])
axes[0].set_title("Distribuição dos Resíduos")
stats.probplot(residuals, dist="norm", plot=axes[1])
axes[1].set_title("Q-Q Plot dos Resíduos")
plt.tight_layout()
plt.savefig("docs-site/docs/operations/assets/residuals_normality.png")
Métricas publicadas (preenchidas quando o gate da §8.3 for atendido — os valores abaixo vêm da execução ilustrativa sobre resíduos sintéticos):
| Métrica | Valor (ilustrativo) | Leitura |
|---|---|---|
| Skewness | pendente | |skew| ≤ 0.5 → ~simétrico; > 1 → assimetria material |
| Kurtosis (excesso) | pendente | ≈ 0 → mesokúrtico; > 3 → caudas pesadas (subestima IC) |
| Shapiro-Wilk p-value | pendente | p < 0.05 rejeita normalidade; em n grande quase sempre rejeita — Q-Q plot manda |
Auditor deve ler ambos juntos: se Shapiro rejeita mas Q-Q é
aproximadamente diagonal e skew/kurt são pequenos, o mean ± std segue
sendo uma síntese honesta. Se Q-Q se afasta nas caudas, intervalos de
confiança gaussianos subestimam a probabilidade de erro extremo e o
cv_rmse_gate da §8.3 deve ser endurecido com percentil P95/P99 do erro
absoluto antes de ir para produção.
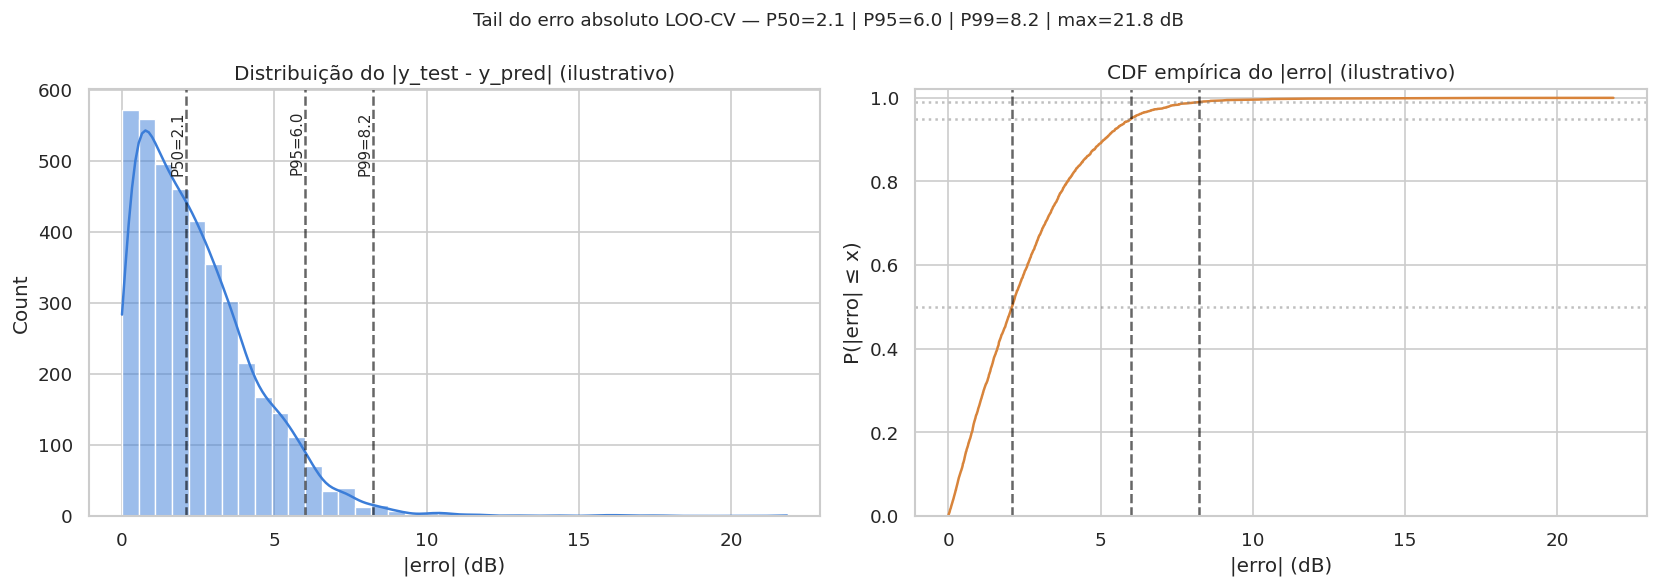
Percentis do erro absoluto (P50/P95/P99/max)¶
Fechando o loop aberto pelo parágrafo anterior: RMSE e mean ± std
sintetizam o erro médio — não dizem o pior caso que um cliente real vai
ver. Para um SLA do tipo "99 % das predições terminam dentro de X dB do
valor medido" o gate precisa de percentis não-paramétricos do
|y_test − y_pred|, agregados sobre todos os folds do LOO-CV. O helper
scripts/plot_abs_error_percentiles.py materializa essa visão:
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

# abs_err = np.abs(np.concatenate([y_test_fold - y_pred_fold for fold in folds]))
pcts = {p: float(np.percentile(abs_err, p)) for p in (50, 75, 90, 95, 99)}
pcts["max"] = float(abs_err.max())
for label, value in pcts.items():
    print(f"{label}: {value:.2f} dB")

fig, axes = plt.subplots(1, 2, figsize=(14, 5))
sns.histplot(abs_err, kde=True, ax=axes[0], bins=40)
for p in (50, 95, 99):
    axes[0].axvline(pcts[p], linestyle="--")
axes[0].set_title("Distribuição do |erro|")

sorted_err = np.sort(abs_err)
cdf = np.arange(1, len(sorted_err) + 1) / len(sorted_err)
axes[1].plot(sorted_err, cdf)
axes[1].set_title("CDF empírica do |erro|")
plt.tight_layout()
plt.savefig("docs-site/docs/operations/assets/abs_error_percentiles.png")
Tabela publicada (preenchida quando o gate da §8.3 for atendido — valores abaixo vêm da execução ilustrativa sobre resíduos sintéticos):
| Métrica | Valor (ilustrativo, dB) | Leitura |
|---|---|---|
| P50 (mediana) | pendente | Erro típico — comparar com RMSE para detectar assimetria |
| P75 | pendente | Quartil superior — 25 % das predições terão erro acima desse valor |
| P90 | pendente | 1 em 10 predições piora a partir daqui |
| P95 | pendente | Candidato a SLA "soft" — mencionar em propostas comerciais |
| P99 | pendente | Candidato a gate de promoção — endurece o cv_rmse_db da §8.3 |
| max | pendente | Pior caso observado no fold — útil para tail-risk mas sensível a outlier único |
Interpretação para auditoria:
- Se
P99 / RMSE≫ 2,5 → resíduos com cauda pesada, e o gate gaussiano da §8.3 (cv_rmse_db < 8 dB) não garante que 99 % das predições fiquem abaixo de 8 dB. Decisão de produto: trocar o gate paraP99(|erro|) < 12 dB(ou similar, calibrado quando o dataset chegar). - Se
P99 / RMSE≈ 2 → resíduos aproximadamente gaussianos e o gate atual é defensável; ainda assim, publicar P95 numa proposta comercial é mais honesto que publicar sóRMSE. maxisolado não vira gate — é métrica de monitoramento para detectar regressão entre releases (maxsubir > 30 % entre versões dispara revisão manual).
| Campo | Valor planejado |
|---|---|
| Tipo de fold | Leave-one-region-out k=5, estratificado por macrorregião IBGE |
| Folds | Norte / Nordeste / Centro-Oeste / Sudeste / Sul |
| Modelos avaliados | Cadeia servida p1812/p1411 + LightGBM residual e ridge-v1 (fallback) |
| Métrica primária | cv_rmse_db por fold + média ± desvio padrão |
| Métricas secundárias | MAE, bias (média do erro com sinal), por banda (700/850/1800/2600/3500 MHz) |
| Critério adicional | Sem regressão por banda vs ridge-v1 em nenhuma região |
8.2 Fontes de dados (apenas fontes auditáveis)¶
| Fonte | Tipo | Uso no fold |
|---|---|---|
link_observations (tabela interna, POST /coverage/observations[/batch]) |
Drive-test e medições CW reais ingeridas por clientes/parceiros | Verdade-base (measured_dBm) |
| ANATEL MOSAICO / SMP | Cadastro público de ERBs e licenciamento | Geometria do enlace (Tx lat/lon, altura, EIRP declarado) |
| OpenCellID | Crowdsourced cell tower database | Cross-check de geometria e descoberta de Rx populados |
NASADEM 30 m → ALOS 30 m → SRTM-3 90 m (cadeia em GET /platform/dem-status) |
NASA / JAXA | Perfil de terreno |
| MapBiomas Coleção 9 | MapBiomas Brasil | Clutter do ridge e clutter_class de /coverage/predict |
| ESA WorldCover e GHSL | ESA / Comissão Europeia | Clutter, altura de edificações e obstrução do percurso no resíduo servido (blocos clutter, building_height, path_obstruction do sidecar) |
Não usamos datasets proprietários não auditáveis, datasets cuja licença não permita uso comercial, nem datasets sem rastreabilidade de origem.
8.3 Gate de promoção¶
O par p1812/p1411 + LightGBM residual já é o caminho default de
/coverage/predict (topo da página). Três portas distintas se aplicam
hoje:
- Troca de artefato.
residual-drift-retrain.ymltreina o candidato e só abre PR se ele passar o teto de CV-RMSE, a melhoria mínima sobre o artefato versionado e a validação conformal; a promoção é o merge humano desse PR (Validação do modelo §3). - Grau sole-source.
GET /coverage/promotion-readiness, quatro portas (topo da página). - Transferência entre regiões (planejada). Exige
$$\text{cv_rmse_db}_{\text{LOO-região}} < 8\ \text{dB}$$
para todas as 5 macrorregiões, e sem regressão por banda vs
ridge-v1 em nenhuma região. Não é medida hoje: os dados reais estão
só no Centro-Oeste. O critério está no documento interno ROADMAP.md (seção Q2→Q3 /
2026 — P.1812 default + LightGBM residual) e a função de validação é
scripts/train_residual_model.leave_one_region_out_cv.
8.4 O que esta página vai publicar quando o fold rodar¶
Quando houver observações reais em mais de uma macrorregião e o fold for executado pela primeira vez, esta seção será atualizada substituindo o status 🟡 por 🟢 e adicionando uma tabela com:
cv_rmse_dbpor região (N / NE / CO / SE / S) — média ± std.- Comparativo da cadeia servida contra o fallback
ridge-v1por região. - Hash do commit que produziu os números + comando reprodutível.
- Snapshot do dataset (
n_real,n_synthetic, data do cut).
Até lá, nenhum número de validação cruzada regional aparece nesta página.
8.5 Camada de diagnóstico de resíduos — três gates estatísticos¶
A validação cruzada regional acima mede acurácia média. Não detecta duas patologias frequentes em modelos físicos+ML: resíduos com estrutura serial (o modelo está deixando sinal previsível na tabela de erros) e resíduos espacialmente correlacionados (o modelo está errando do mesmo jeito na mesma vizinhança geográfica). Para cobrir esses dois ângulos, existem três gates independentes:
| Gate | Pergunta que responde | Teste | Onde rodar |
|---|---|---|---|
| Ljung-Box ordenado | Resíduos têm autocorrelação ao longo do tempo de medição ou ao longo da distância TX→RX? | Q(h) ~ χ²(h), α=0.05 nos lags 10/20/40 | scripts.train_residual_model.leave_one_region_out_ljung_box + scripts.calibrate_propagation_for_br.climate_promotion_gate |
| Moran's I | Resíduos formam clusters geográficos (mesmo erro em torres vizinhas)? | I com pesos KNN sobre distância haversine, z-score gaussiano | scripts.calibrate_propagation_for_br.spatial_promotion_gate |
| CV temporal | Performance degrada com o tempo (drift de hardware, refresh de rede, sazonalidade)? | Forward-chaining TimeSeriesSplit k=5 |
scripts.train_residual_model.time_series_cv |
Política dos gates (calibração de clima e promoção de resíduo)¶
- Lag de decisão: 20 (cobre eventos >5σ em AR(1) com φ=0.6).
- α: 0.05.
- Tolerância: no máximo 1 das 5 macrorregiões pode rejeitar H0 em qualquer das duas ordenações (temporal ou distância) sem bloquear a promoção. Justificativa: com α=0.05 em 5×2=10 testes independentes sob H0, espera-se ~0.5 rejeição espúria por candidato; tolerar uma rejeição absorve esse falso positivo sem permitir um modelo realmente patológico. Endurecer para 0 faria o gate piscar.
- Moran's I: mesma tolerância (1 de 5 regiões); regiões com
n < k+2produzem linha NaN e não contam como rejeitantes.
Por que três gates e não um¶
Cada teste responde uma pergunta que os outros dois não respondem:
- Ljung-Box temporal detecta autocorrelação em série temporal (drive-test em sequência) mas é cego para pontos espacialmente próximos que foram medidos em campanhas distintas.
- Ljung-Box distância detecta estrutura ao longo de um único caminho TX→RX; é cego para nuvens de pontos com múltiplos transmissores.
- Moran's I cobre exatamente o gap acima — nuvens não ordenadas de
pontos
(lat, lon), como o cadastro Anatel completo de uma região.
Implementação e cobertura de testes¶
A camada está em:
rf_engines/diagnostics.py— Ljung-Box reimplementado emnumpy+scipy.stats.chi2(sem nova dependência top-level; validado bit-exato contrastatsmodels.acorr_ljungboxem cross-check único). Funções:ljung_box,ljung_box_time_ordered,ljung_box_distance_ordered.rf_engines/spatial_diagnostics.py— Moran's I com pesos KNN haversine, variância pela hipótese de randomização (Cliff & Ord 1981 §2.5). Função principal:morans_i(emorans_i_by_regionpara tabela por macrorregião).- Cobertura: testes em
tests/test_ljung_box_diagnostics.py,tests/test_spatial_diagnostics.py,tests/test_loo_region_ljung_box.py,tests/test_temporal_cv.pyetests/test_calibrate_climate_gate.py. Inclui ruído branco (não rejeita), AR(1)(φ=0.6) (rejeita em ≥ 4 de 5 regiões), clusters latitudinais (Moran's I rejeita), drift linear no tempo (CV temporal mostra RMSE crescente), e todas as validações de input (length mismatch, n insuficiente, variância zero).
Status: camada de diagnóstico implementada. Ela não é porta do
retreino do resíduo: residual-drift-retrain.yml não a chama (as portas
desse workflow estão em
Validação do modelo §3).
9. Resumo — o plano de 2026-Q2 e o estado em 10/10/2026¶
| Mudança | Por quê | Estado em 10/10/2026 |
|---|---|---|
Promover p1812 a engine default (com fspl como fallback) |
Eliminar a crítica "FSPL dominante no caminho default" | Feito. p1812 é o default de /coverage/predict; o fspl ficou em /analyze_link, /coverage/interference e no PDF (§2) |
| LightGBM residual sobre P.1812 | Alvo cv_rmse_db < 8 dB |
Em produção. O CV espacial h3_res8 do artefato servido está na tabela do topo da página (gerada do artefato); o fold geográfico por região segue pendente |
| Ridge-v1 → fallback | Manter compatibilidade offline / cold-start | Feito (§3) |
| Migrar SRTM 90 m → NASADEM 30 m | Resolver Fresnel em terreno acidentado | Feito. Cadeia nasadem+alos+srtm3 (§5) |
| Holdout estratificado leave-one-region-out | Eliminar viés geográfico no cv_rmse_db |
Pendente — dados reais só no Centro-Oeste (§8) |
| Guard determinístico anti-alucinação IA | Eliminar risco regulatório | Pendente a comparação numérica da §6; o código tem guardas de forma (bedrock_output_guard.py) e de citação (bedrock_citation_guard.py) |
O cronograma interno está em ROADMAP.md.